DORA (Digital Operational Resilience Act) est un règlement européen datant du 14 décembre 2022 entré en application en France depuis le 17 janvier 2025.
Ce règlement s’applique à l’ensemble des entités financières et à leurs sous-traitants TIC considérés comme critiques (ou des sous-traitants qui ont des obligations contractuelles) sur l’ensemble de la chaîne portant sur 5 piliers :

TIC : Technologies de l’information et de la communication
- Gestion du risque TIC : C’est l’anticipation avec une nécessité de faire une cartographie de l’ensemble de son système d’information, quel système communique avec quoi, sauvegarde présente et testée, plan de continuité, plan de reprise d’activité, etc… Nous détaillons ce sujet un peu plus bas dans l’article.
- Gestion des incidents TIC : Réagir et déclarer, quand un incident majeur se produit (pas forcément lié à la sécurité, il peut s’agir d’une simple panne technique), il doit être déclaré soit au régulateur dans le cadre d’une entité financière, soit à l’entité financière dans le cadre d’une sous-traitance (exemple : Rapport SLA)
- Tests de résilience : Principalement un audit de sécurité interne et/ou externe. Pour certaines entités importantes (la liste en question est confidentielle), il est également nécessaire de faire tous les trois ans un TLPT (Threat-Led Penetration Testing), il s’agit de tests pilotés par la menace actuelle, on reprend des techniques actuelles des cybercriminels afin de faire le test. C’est aussi s’assurer que l’application continue de tourner malgré des dégradations (exemple : déploiement en multizone 3-AZ, si un des trois datacenters est indisponible, l’application doit continuer à tourner, même principe sur du multi-providers).
- Risque lié aux prestataires tiers : Surveillance de toute la chaîne de sous-traitance via un registre de l’ensemble des contrats TIC, clauses obligatoires (audit, réversibilité, localisation des données).
- Partage d’informations : Facultatif et exclusivement réservé aux entités financières, consiste au partage d’information sur de nouvelles techniques d’attaque entre ces entités pour permettre une réactivité plus élevée, les sous-traitants peuvent être inclus à ce partage d’information mais la décision revient à l’entité financière.
Dans le cadre de notre article, nous allons principalement parler de la gestion des risques d’un point de vue technique.
Un peu de contexte
Mais avant ça… un peu de contexte sur la cybersécurité aujourd’hui pour comprendre pourquoi, malgré l’obligation, il reste essentiel de mettre en place des moyens afin de se protéger.

361 c’est le nombre de fuites de données (recensé au 22 septembre 2026) de l’année courante.
Il existe pas mal de facteurs pouvant expliquer ces fuites de données comme :
- Le manque de moyens.
- La montée en puissance de l’IA facilitant les attaques.
- Le manque de sanction de la CNIL (16 sanctions sur 2026 vs 652 sanctions sur 2026 pour l’AEPD équivalent espagnol )
- Les enjeux géopolitiques.
- Les utilisateur.rices non sensibilisé.es.

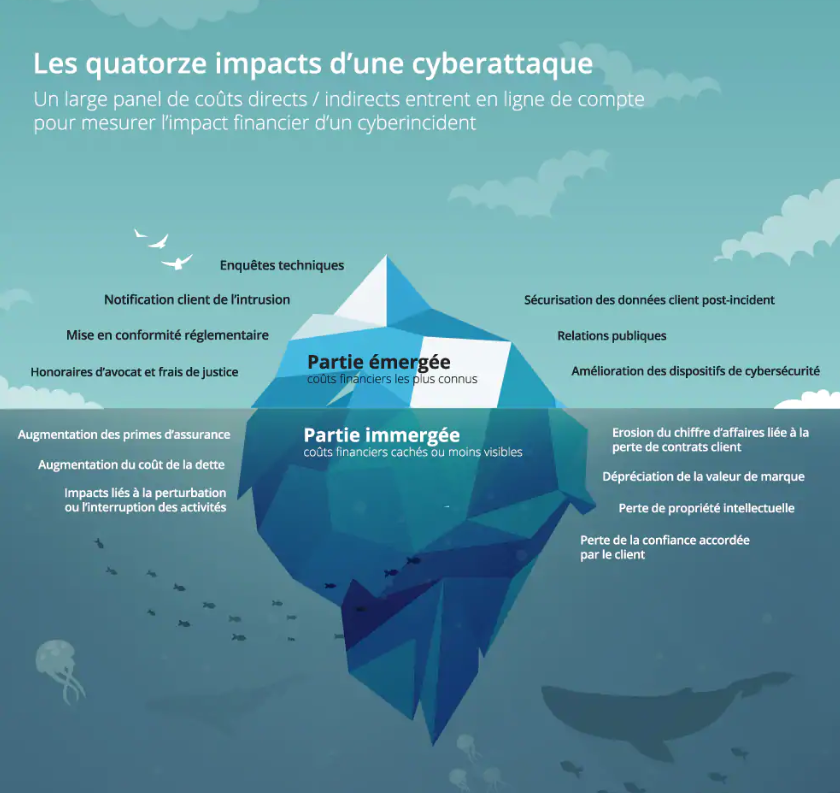
Source : https://www.senat.fr/rap/r20-678/r20-67812.png
Comme on peut le voir sur l’image ci-dessus, une entreprise ou administration a tout intérêt à sécuriser un maximum son système d’information sous peine de subir ces différents impacts.
Marie-Laure DENIS (présidente de la CNIL) le conseille également :
Ça sera toujours moins coûteux d’investir en matière de protection et de sécurisation de ses systèmes d’information que d’être victime d’une attaque – Cash Investigation du 10 septembre 2026
Et DORA dans tout ça ?
A contrario de l’ISO 27001 et de NIS 2, aucune entité officielle française ne propose de “guide” pour DORA afin de se mettre en conformité, il est donc assez difficile pour une entreprise de savoir quelle direction prendre afin d’être conforme…
Côté ISO 27001, vous pouvez retrouver le guide officiel fourni par l’ISO : https://www.iso.org/fr/standard/27001
Côté NIS 2, vous pouvez retrouver le guide ReCyF fourni par l’ANSSI : https://messervicescyber-ressources.cellar-c2.services.clever-cloud.com/20260317_NIS_V2_ReCyF_v2.5.pdf
Côté RGPD, la CNIL a publié un guide en 2024 sur la sécurité des données personnelles : https://www.cnil.fr/sites/cnil/files/2024-03/cnil_guide_securite_personnelle_2024.pdf
En dehors de tout ça, il existe aussi le guide d’hygiène informatique fourni par l’ANSSI : https://messervices.cyber.gouv.fr/guides/guide-dhygiene-informatique
En revanche, bonne nouvelle, si vous êtes déjà conforme à l’ISO 27001 et/ou NIS 2 il est plus que probable que certaines pratiques déjà en place puissent être réutilisées pour DORA, notamment en ce qui concerne la gestion des risques.
Gestion du risque TIC
Avant la technique : la gouvernance
DORA est très clair sur un point : la gestion du risque TIC n’est pas qu’une affaire d’équipe technique. C’est la direction (“l’organe de direction” dans le texte) qui en porte la responsabilité finale. Concrètement, elle doit :
- définir et approuver le cadre de gestion du risque TIC et la stratégie de résilience opérationnelle numérique.
- valider les politiques clés (PCA/PRA, gestion des accès, gestion des incidents, recours aux prestataires).
- allouer un budget suffisant.
- être tenue informée des incidents majeurs et des résultats des tests.
- se former elle-même au risque TIC.
Et ce n’est pas symbolique : DORA prévoit que des sanctions puissent viser directement les membres de la direction (article 50).
C’est une obligation dans le cadre de DORA et elle est abordée dans les articles 5 et 6.
Il existe trois types de risque :
- Le risque technique
- Le risque humain (sensibilisation)
- Le risque physique
Dans le cadre du risque technique, nous avons identifié ces différents sujets :
- Cartographie du système d’information
- Gestion PRA / PCA
- Surveillance de l’activité et remontée d’alerte
- Veille sécurité et surveillance CVE
- Surveillance de la chaîne d’approvisionnement
- Gestion des droits du système d’information et applicatif
- Bonnes pratiques diverses
Un exemple de risque associé est ajouté plus bas dans le détail de chaque point.
Vous pouvez faire votre gestion de risque via la méthode EBIOS Risk Manager
Un équilibre est toutefois à trouver selon les moyens de l’entreprise, vous n’allez pas mettre en place un scan rétinien pour entrer dans les locaux d’une entreprise de dix personnes… C’est ce qu’on appelle le « Principe de proportionnalité » (Article 4 DORA).
Le risque technique
Cartographie du système d’information
On ne peut protéger, surveiller et restaurer que ce que l’on connaît. La cartographie est donc le socle de tout le reste : sans elle, impossible de savoir quoi mettre dans le PRA, si une CVE vous concerne ou quel serveur oublié est encore exposé sur internet.
Inventorier les actifs
Exemples d’actifs à inventorier : applications, serveurs, bases de données, services cloud, équipements réseau, postes de travail, etc…
Côté outillage, l’idéal est d’automatiser au maximum, car un inventaire tenu à la main est obsolète au bout de trois mois :
- L’Infrastructure as Code (Terraform, manifests Kubernetes) comme source de vérité de ce qui est déployé.
- Les inventaires natifs des hébergeurs (Cloud Asset Inventory chez GCP, AWS Config, etc…) pour détecter ce qui a été créé en dehors de l’IaC.
- Un catalogue de services comme Backstage pour savoir qui est responsable de quel service et ce dont il dépend.
- Les SBOM générés en CI (CycloneDX) pour la partie logicielle, que nous verrons dans la partie veille CVE.
C’est une obligation dans le cadre de DORA et elle est abordée dans l’article 8.
Gestion PRA / PCA
Le plan de reprise d’activité (PRA) et plan de continuité d’activité (PCA) sont des dispositifs permettant aux entreprises de garantir une activité continue et avec le moins d’interruption de service possible.
Pour DORA ces dispositifs sont vitaux et permettent de garantir la résilience.
Un PRA doit être repris et testé régulièrement (au moins une fois par an), si possible, il doit être testé par des personnes n’ayant pas de connaissance sur le projet pour s’assurer que la documentation est claire et sans oubli.
Associées au PRA, les sauvegardes doivent être dupliquées et stockées de manière sécurisée selon le principe de la règle (3-2-1-1-0).
Nous vous recommandons de chiffrer vos sauvegardes à l’aide d’un outil de chiffrement tel que OpenPGP ou Age et de stocker la clé de chiffrement de manière sécurisée dans un coffre-fort numérique.
Et enfin, comme le recommande l’article ci-dessus, de vous assurer de l’immuabilité de vos sauvegardes (WORM storage).
Il y a plusieurs solutions à cela :
- Côté S3 il est possible de mettre en place de l’Object Lock : https://docs.aws.amazon.com/AmazonS3/latest/userguide/object-lock.html
- Certains NAS proposent de faire des snapshots immuables, même une personne avec des droits d’administration ne peut pas les supprimer : https://kb.synology.com/fr-fr/DSM/tutorial/what_is_an_immutable_snapshot
- Éditeur de solution de sauvegarde dédiée possédant une solution WORM (Veeam, Rubrik, etc…)
Un PCA peut être assuré à l’aide :
- De la haute disponibilité côté Infrastructure (duplication des applications, clusters de base de données primaire et secondaires, datacenter 3-AZ).
- D’un SOC (Security Operations Center)
- D’une astreinte.
Exemple de risque en cas d’absence d’un PRA/PCA :
- Interruption de service suite à une panne technique.
- Perte de données suite à une cyberattaque type ransomware.
C’est une obligation dans le cadre de DORA et elle est abordée dans les articles 11 et 12.
Surveillance de l’activité et remontée d’alerte
Un reproche qui a été fait à Free pendant la procédure de sanction avec la CNIL :
La société n’avait pas mis en œuvre des mesures adaptées pour détecter des comportements anormaux. (Source Cash Investigation du 10 septembre 2026 – 00’52)
Ce reproche n’est pas lié à DORA, puisque Free n’est pas une entité financière, mais c’est bien pour démontrer le fait que n’importe quelle entreprise pourrait subir le même reproche et que la mise en place d’un système de détection d’intrusion est vitale.
Une exfiltration de données peut durer des semaines sans que personne ne s’en rende compte si rien ne surveille l’activité. L’objectif est de centraliser les informations, de détecter ce qui sort de l’ordinaire et d’alerter la bonne personne au bon moment.
Voici les briques que nous vous recommandons :
- Un SIEM (Security information and event management) : il centralise les journaux (systèmes, applicatifs, pare-feu, cloud), corrèle les évènements et lève des alertes. Par exemple : des connexions SSH en échec à répétition, une élévation de privilèges, ou la modification d’un fichier sensible grâce au contrôle d’intégrité. Il existe différentes solutions comme Splunk, Wazuh, Microsoft Sentinel, etc…
- Un EDR (Endpoint Detection and Response) sur les postes de travail et les serveurs : il détecte les comportements suspects, comme le chiffrement massif de fichiers typique d’un ransomware ou l’exécution d’un script inhabituel, et peut isoler automatiquement la machine du réseau. Il en existe plusieurs comme OpenEDR, Microsoft Defender for Endpoint, SentinelOne Singularity, etc…
- Un WAF (Web Application Firewall) en amont de vos applications : il filtre le trafic HTTP malveillant (injections SQL, XSS, bots, bruteforce, etc…). Côté cloud, la plupart des hébergeurs en proposent un (Cloud Armor chez GCP ou encore AWS WAF par exemple). Côté open source, ModSecurity ou Coraza avec l’OWASP Core Rule Set font très bien le travail. Nous vous conseillons de le passer d’abord en mode détection pour ajuster les règles, puis en mode blocage, afin d’éviter de bloquer vos propres utilisateur.rices.
- Un gestionnaire de suivi d’erreur pour la remontée d’erreurs applicatives : ce n’est pas un outil de sécurité à proprement parler, mais un pic soudain d’erreurs peut trahir une tentative d’exploitation (requêtes malformées, fuzzing, etc…). Il en existe plusieurs comme Bugsink, Sentry, GlitchTip.
- Supervision : Sur des solutions comme Prometheus / Grafana, Datadog, etc … Nous vous recommandons de construire trois types de tableaux de bord, car chacun répond à une question différente :
- Board métier : « Est-ce que l’activité est normale ? » On y suit le nombre d’inscriptions, de transactions, souscriptions, contrôles, etc… Une chute brutale (zéro transaction depuis 15 minutes) révèle une panne silencieuse que les sondes techniques n’ont pas vue. Un pic anormal (500 créations de comptes en une heure) peut révéler une attaque par bots.
- Board technique : « Est-ce que l’infrastructure tient ? » On y suit le CPU, RAM, le réseau, le taux d’erreurs 5xx, les pods qui redémarrent en boucle, l’espace disque, la date d’expiration des certificats TLS, et le statut des dernières sauvegardes.
- Board sécurité : « Est-ce qu’on est attaqué ? » On y suit les tentatives de connexion échouées, les réponses 401/403, les requêtes bloquées par le WAF, les connexions depuis des pays inhabituels, les accès aux interfaces d’administration, les exports de données volumineux et les alertes remontées par Wazuh.
Une alerte que personne ne lit ne sert à rien. Attention aussi à la fatigue d’alerte : trop d’alertes tue l’alerte, il faut remonter les alertes les plus critiques dans les canaux spécifiques type Teams ou Mail et garder le reste des alertes dans un tableau de bord dédié et les consulter de temps en temps.
Pensez à conserver vos journaux suffisamment longtemps (la CNIL recommande entre 6 mois et 1 an) et hors de portée d’une personne malveillante : la première chose qu’elle fait une fois entré, c’est souvent d’effacer ses traces.
Exemple de risque en cas d’absence de surveillance :
- Exfiltration de données pendant plusieurs semaines sans aucune détection.
- Découverte d’une fuite de données via des médias.
C’est une obligation dans le cadre de DORA et elle est abordée dans l’article 10.
Veille sécurité et surveillance CVE
Plus de 48 000 vulnérabilités (CVE) ont été publiées en 2025, et le délai entre la publication d’une faille et son exploitation ne fait que se réduire, d’autant plus avec l’IA qui facilite l’écriture d’exploits. Il ne s’agit donc pas de tout lire, mais de savoir rapidement si vous êtes concerné.e.

Et pour ça, il faut d’abord savoir ce que vous utilisez : on ne peut surveiller que ce que l’on connaît. D’où l’importance de la cartographie du système d’information évoquée plus haut.
Faire de la veille :
- Suivre les alertes et avis du CERT-FR https://www.cert.ssi.gouv.fr/.
- S’abonner aux CVE des éditeurs et produits que vous utilisez via OpenCVE https://www.opencve.io/, pour ne recevoir que ce qui vous concerne.
Maintenir à jour ses dépendances applicatives, middleware, système d’exploitation :
- Privilégier les versions LTS et surveiller les dates de fin de vie (https://endoflife.date/ est très pratique pour ça).
- Définir des délais de correction selon la criticité, par exemple : faille critique exposée sur internet immédiatement, faille élevée sous 7 jours, le reste lors des mises à jour planifiées.
Scanner ses CVE :
- Mettre en place un outil côté CI/CD pour analyser au build comme Trivy ou Dependency Track avec du CycloneDX.
- Ajouter également un outil similaire mais cette fois-ci à l’intérieur de votre cluster Kubernetes comme Kubescape, qui analyse les CVE des images déployées, mais également la configuration de votre cluster (conteneurs lancés en root, privilèges excessifs, absence de network policies, etc…).
Une CVE critique n’est pas forcément exploitable chez vous (composant non exposé, fonctionnalité non utilisée), c’est pour cette raison qu’il faut analyser et planifier la mise à jour selon la « vraie » criticité.
Exemple de risque en cas d’absence de veille et surveillance CVE :
- Exploitation d’une faille publique non corrigée (Log4Shell, découverte en 2021, encore exploitée aujourd’hui).
- Mauvaise configuration du cluster permettant à un conteneur compromis de s’échapper vers le nœud.
Surveillance de la chaîne d’approvisionnement
On parle ici de la chaîne d’approvisionnement logicielle : tout ce code que vous n’avez pas écrit mais que vous exécutez quand même (dépendances npm, actions GitHub, images Docker, etc…). Pour un attaquant, compromettre un seul paquet populaire permet de toucher des milliers de projets d’un coup.
Deux exemples récents :
- Mars 2025 : l’action GitHub tj-actions/changed-files, utilisée par des dizaines de milliers de dépôts, a été compromise. Ses tags ont été modifiés pour pointer vers un commit malveillant qui affichait les secrets de la CI dans les logs.
- Septembre 2025 : des paquets NPM extrêmement populaires (chalk, debug, etc…) ont été compromis suite au vol d’un compte NPM, suivi quelques jours plus tard par le ver Shai-Hulud, qui se propageait de paquet en paquet en volant les tokens des développeur.euses.
Le principe commun des solutions ci-dessous : ne pas faire confiance aveuglément à la dernière version, et épingler par empreinte (hash) plutôt que par nom. Un tag peut être déplacé, un hash non.
Côté dépendances dans l’écosystème JavaScript :
Abandonner NPM / Yarn et privilégier plutôt PNPM, qui permet de refuser les versions publiées trop récemment. La plupart des paquets malveillants sont détectés et retirés en quelques heures : attendre 24h suffit donc à éviter une bonne partie des attaques.
# pnpm-workspace.yamlminimumReleaseAge: 1440 # en minutes, soit 24hstrictDepBuilds: trueblockExoticSubdeps: trueallowBuilds: '@example/dependance': true
Autre bon point : PNPM n’exécute plus par défaut les scripts postinstall des dépendances (vecteur d’attaque classique), il faut les autoriser explicitement via allowBuilds. Et bien sûr, le fichier pnpm-lock.yaml doit être commité et le projet doit être installé avec pnpm ci aussi bien en local que côté CI pour ne pas mettre à jour le fichier pnpm-lock.yaml.
Pour en savoir plus : https://pnpm.io/supply-chain-security
Côté CI/CD (GitHub Actions) :
Référencer les actions par le SHA complet du commit plutôt que par un tag, et garder le tag en commentaire pour la lisibilité :
# ❌ Le tag v4 peut être déplacé vers un autre commit- uses: actions/checkout@v4# ✅ Le SHA est immuable- uses: actions/checkout@<sha-complet-du-commit> # v4.x.x
Épingler ses actions ne suffit pas toujours : les workflows eux-mêmes peuvent contenir des failles de configuration. Nous vous recommandons de les analyser avec zizmor https://docs.zizmor.sh/ qui est un outil d’analyse statique dédié aux GitHub Actions.
Il détecte notamment :
- les actions non épinglées par SHA.
- les permissions trop larges accordées au GITHUB_TOKEN.
- les injections de template.
Côté images Docker :
Un tag Docker peut être réécrit à tout moment. Ajoutez le digest sha256 en plus de la version :
FROM node:26-alpine@sha256:<digest-de-l-image>
Côté déploiement Kubernetes :
Même principe dans vos manifests, afin de garantir que l’image déployée en production est exactement celle qui a été testée :
image: registry.mon-entreprise.fr/mon-app:1.0.0@sha256:<digest-de-l-image>
Pour aller plus loin, une politique d’admission (OPA Gatekeeper ou Kyverno par exemple) peut refuser tout déploiement d’images non épinglées ou non signées.
Exemple de risque en cas d’absence de sécurité sur la chaîne d’approvisionnement :
- Installation d’une dépendance compromise qui vole les tokens et secrets des postes des développeur.euses et de la CI.
- Déploiement en production d’une image différente de celle testée (tag écrasé).
Gestion des droits du système d’information et applicatif
Le principe est simple : chaque personne ne doit avoir accès qu’à ce dont elle a besoin, et uniquement le temps où elle en a besoin. C’est ce qu’on appelle le principe du moindre privilège.
Dans les faits, c’est souvent là que le bât blesse… Les accès s’accumulent au fil des projets, et les comptes d’ancien.nes salarié.es ou prestataires restent actifs des mois (voire des années) après leur départ. Ces comptes oubliés sont une porte d’entrée idéale pour une personne malveillante : personne ne les utilise, donc personne ne remarque quand quelqu’un s’en sert.
Mettre en place une procédure d’offboarding :
Quand une personne quitte le projet ou l’entreprise, une checklist doit être déroulée le jour même de son départ pour désactiver ou supprimer l’ensemble de ses accès :
- Applications métiers, sur l’ensemble des environnements (QA, préprod, production).
- Compte lié au gestionnaire d’identité (Entra ID, Keycloak, Google Workspace, etc…).
- Messagerie instantanée (Slack, Teams, etc…).
- Outils divers : Atlassian, GitHub, VPN, etc…
- Accès physique : récupération du badge, code alarme.
Évidemment, l’usage d’un SSO est recommandé pour faciliter l’onboarding et l’offboarding : on désactive un seul compte et tous les accès tombent. Mais dans la plupart des outils, le SSO est une fonctionnalité payante, généralement réservée aux offres les plus élevées (on parle même de « SSO tax », cf. https://sso.tax/). Il peut donc être difficile pour une entreprise d’avoir une véritable authentification centralisée sans y laisser des milliers d’euros…
Une approche pragmatique : centraliser en priorité les outils les plus critiques (hébergeur, dépôts de code, accès production), et pour le reste, tenir à jour un registre de qui a accès à quoi. C’est ce registre qui rendra l’offboarding fiable.
Faire une revue des accès régulière :
Même avec une bonne procédure d’offboarding, il y a toujours des oublis. Une revue des comptes doit donc être faite régulièrement (par exemple tous les 6 mois, et plus souvent pour les accès critiques). On peut s’inspirer de la checklist d’offboarding et vérifier, outil par outil :
- les comptes inactifs ou appartenant à des personnes parties,
- les droits excessifs (une personne admin alors qu’elle n’en a plus besoin),
- les comptes de service et les accès prestataires encore actifs.
Côté applicatif :
La gestion des droits ne s’arrête pas aux outils internes, elle concerne aussi vos propres applications. Chaque endpoint doit vérifier non seulement que l’utilisateur.rice est connecté.e, mais aussi qu’il ou elle a le droit d’accéder à cette ressource. Le contrôle d’accès défaillant arrive d’ailleurs en tête du classement OWASP Top 10 des vulnérabilités web.
Exemple de risque en cas d’absence de gestion des droits :
- Ancien.ne salarié.e ou prestataire ayant toujours accès à la console cloud ou au dépôt GitHub plusieurs mois après son départ.
- Compte oublié, sans double authentification, compromis via des identifiants issus d’une fuite de données.
- Utilisateur.rice accédant aux données d’un.e autre client.e simplement en modifiant un identifiant dans l’URL.
C’est une obligation dans le cadre de DORA et elle est abordée dans l’article 9.
Bonnes pratiques diverses
Pour finir sur le risque technique, voici une liste de bonnes pratiques qui, prises une par une, peuvent sembler anodines, mais qui mises bout à bout réduisent considérablement la surface d’attaque.
Côté authentification :
- Politique de mot de passe : la longueur compte plus que la complexité. La CNIL recommande au minimum 12 caractères mêlant majuscules, minuscules, chiffres et caractères spéciaux. Vous pouvez aussi refuser les mots de passe déjà présents dans des fuites connues (l’API Have I Been Pwned le permet sans transmettre le mot de passe).
- Double authentification : à activer partout où c’est possible, en priorité sur les comptes d’administration, les hébergeurs, les dépôts de code et la messagerie. Privilégiez le TOTP (application d’authentification) ou WebAuthn (clé de sécurité, passkey). Évitez le SMS, vulnérable au SIM swapping : une personne malveillante convainc votre opérateur de transférer votre numéro sur sa propre carte SIM et reçoit vos codes à votre place.
- Anti-bruteforce : limiter le nombre de tentatives de connexion (rate limiting, blocage temporaire du compte ou de l’IP).
Côté applicatif :
- En-têtes de sécurité : quelques lignes de configuration suffisent à se protéger contre toute une famille d’attaques (XSS, clickjacking, downgrade HTTP, etc…). Vous pouvez tester votre site avec le Mozilla Observatory.
- Éviter l’affichage d’informations techniques : les en-têtes
ServeretX-Powered-By, les stack traces dans les pages d’erreur ou une version affichée dans le pied de page sont autant d’indices pour une personne malveillante. Elle n’a plus qu’à chercher les CVE correspondantes à votre version…
La Content-Security-Policy est à adapter selon votre application : trop stricte, elle peut bloquer vos propres scripts. Pensez à la tester en mode Content-Security-Policy-Report-Only avant de l’activer.
Côté infrastructure :
- Filtrage IP : les interfaces d’administration, les back-offices, l’accès SSH et les bases de données ne doivent jamais être exposés directement sur internet. Ils doivent être accessibles uniquement via VPN ou depuis une liste d’IP autorisées. Des outils comme Shodan scannent en permanence internet, et une base de données exposée est trouvée en quelques heures.
- Images Distroless : des images de conteneurs qui ne contiennent que votre application et ses dépendances d’exécution, sans shell ni gestionnaire de paquets (Google Distroless, Chainguard, etc…). Résultat : moins de CVE à gérer, et une personne malveillante qui parviendrait à entrer dans le conteneur se retrouverait sans aucun outil. À combiner avec un utilisateur non-root et un système de fichiers en lecture seule.
- Trafic réseau chiffré : utiliser uniquement des protocoles chiffrés (HTTPS, SFTP, SSH) avec les derniers standards (TLS 1.3, ou TLS 1.2 au minimum), et désactiver les anciennes versions. Vous pouvez vérifier votre configuration avec SSL Labs. N’oubliez pas le trafic interne entre vos services : le réseau interne n’est pas une zone de confiance.
Côté postes de travail :
- Antivirus : sur l’ensemble des postes et serveurs. Si un EDR est déjà en place, il couvre généralement ce besoin. Pensez aussi aux fichiers envoyés par vos utilisateur.rices sur vos applications, qui peuvent être analysés avec ClamAV par exemple.
- Chiffrement des disques : BitLocker sous Windows, FileVault sous macOS, LUKS sous Linux. Un PC portable volé et non chiffré, c’est l’ensemble de ses données accessibles en retirant simplement le disque. Et bien sûr, les clés de récupération doivent être stockées de manière sécurisée.
Côté échanges :
- Transmission d’informations sensibles : pas de mot de passe ou de fichier sensible envoyé en clair par mail ou sur Slack, où ils resteront stockés indéfiniment. Utilisez un SFTP ou un lien sécurisé temporaire à usage unique (Bitwarden Send, PrivateBin, etc…) si possible sur un serveur vous appartenant.
Côté localisation des données :
Un enjeu aujourd’hui est la souveraineté des données, avez-vous la garantie que vos données stockées en dehors de la France vous seront toujours accessibles notamment en cas de conflit géopolitique ?
Il existe aujourd’hui plusieurs hébergeurs français majeurs permettant d’en garantir la souveraineté, par exemple OVHcloud, Scaleway, S3NS, etc…
La localisation des données n’est pas une obligation DORA, rien ne vous impose de devoir héberger vos données sur le sol français ou même européen, en revanche vous devez connaître contractuellement leur localisation et évaluer les risques.
Cette liste n’est pas exhaustive. Pour aller plus loin, le guide d’hygiène informatique de l’ANSSI est une excellente base. Et comme toujours, principe de proportionnalité : commencez par ce qui protège vos actifs les plus critiques.
Le risque humain
On peut mettre en place toutes les solutions techniques possibles, si un.e collaborateur.rice clique sur un lien de phishing et saisit ses identifiants (et/ou envoie son certificat VPN), tout cela ne sert plus à grand-chose…
L’humain reste aujourd’hui l’une des principales portes d’entrée des attaquant.es.
Et avec la montée en puissance de l’IA, les attaques deviennent de plus en plus crédibles : fini les mails de phishing bourrés de fautes d’orthographe, place aux mails parfaitement rédigés, personnalisés à partir de données issues de fuites, voire aux deepfakes vocaux pour se faire passer pour un.e dirigeant.e (notamment dans le cas de l’arnaque au président).
Formation aux bonnes pratiques de sécurité
La formation doit concerner l’ensemble des collaborateur.rices, direction comprise, et pas uniquement les équipes techniques. Elle doit être faite à l’arrivée de chaque nouvelle personne (onboarding) puis renouvelée régulièrement (au moins une fois par an).
Voici quelques bonnes pratiques :
- Verrouiller systématiquement son poste de travail
- Ne pas noter ses mots de passe sur des post-it ou dans un fichier en clair, nous vous recommandons l’usage d’un gestionnaire de mots de passe tel que Bitwarden ou KeePassXC (KeePassXC étant certifié par l’ANSSI)
- Ne pas utiliser de générateur de mot de passe / hash en ligne, rien ne garantit que le mot de passe ou hash généré n’est pas conservé côté site. Les gestionnaires de mots de passe cités ci-dessus intègrent leur propre générateur. Dans le cas des générateurs de hash, il vaut mieux passer par le CLI, les outils natifs comme openssl permettent de générer des hash localement.
- Se méfier des tentatives d’arnaques : phishing par mail, SMS ou appel, mais aussi utilisation de données issues de fuites pour se faire passer pour une personne de confiance (banque, collègue, prestataire, etc…). En cas de doute, on vérifie l’identité de la personne par un autre canal.
- Signaler tout comportement suspect au SI, sans crainte d’être blâmé.e. Un incident signalé rapidement est un incident qui peut être contenu.
Pour aller plus loin, il est possible de réaliser des campagnes de simulation de phishing afin de mesurer le niveau de sensibilisation des équipes.
Exemple de risque en cas d’absence de formation :
- Vol d’identifiants suite à une campagne de phishing.
- Virement frauduleux suite à une arnaque au président.
Chocoblast suite à un poste de travail non verrouillé.- Vol d’information via un accès physique sur un poste de travail non verrouillé. Il est très facile d’exfiltrer des données d’un poste en quelques secondes via une clé USB qui agit comme un clavier.
C’est une obligation dans le cadre de DORA et elle est abordée dans l’article 13.
Le risque physique
L’objectif est simple : seules les personnes autorisées doivent pouvoir accéder aux locaux, et encore moins de personnes à la salle serveur.
- L’accès à l’entreprise est-il sécurisé (badge, code, accueil) ?
- Une alarme est-elle en place en dehors des heures d’ouverture ?
- Les passages par badge sont-ils tracés et consultables ?
- Une vidéosurveillance est-elle en place sur les zones sensibles (en respectant les règles de la CNIL) ?
- La salle serveur est-elle fermée à clé avec un accès restreint aux seules personnes qui en ont besoin ?
- Chaque visite est-elle enregistrée et accompagnée ?
- Les badges sont-ils désactivés lors du départ d’une personne ?
- Si votre infrastructure est hébergée chez un prestataire (cloud ou datacenter), la sécurité physique est déléguée à ce dernier. Dans ce cas, il faut s’assurer de son niveau de sécurité via ses certifications (ISO 27001, SecNumCloud, etc…) et les clauses contractuelles, ce qui rejoint le pilier Risque lié aux prestataires tiers.
Exemple de risque en cas d’absence de sécurité physique :
- Vol de matériel contenant des données sensibles (PC portable, disque dur, serveur).
- Intrusion d’une personne extérieure ou ancienne salariée ayant encore un badge actif.
- Impossibilité de retracer les évènements suite à un vol ou une dégradation.
C’est une obligation dans le cadre de DORA et elle est abordée dans l’article 9.
Gestion des incidents TIC
Un incident finira forcément par arriver : panne d’un serveur, erreur de déploiement, fuite de données, ransomware… La question n’est pas de savoir s’il arrivera, mais comment vous allez réagir. Et c’est là que DORA est le plus exigeant : il ne suffit plus de corriger l’incident, il faut le détecter, le classer, le déclarer dans les délais et en tirer des leçons.
Préparer avant l’incident
Le pire moment pour réfléchir à la gestion d’un incident, c’est pendant l’incident. Tout doit être préparé en amont :
- Une procédure de gestion des incidents documentée et connue des équipes : qui détecte, qui décide, qui communique, qui corrige.
- Une liste de contacts à jour : astreinte, direction, DPO, régulateur, prestataire de réponse à incident (idéalement qualifié PRIS par l’ANSSI), assureur cyber, client.es pour un sous-traitant, etc…
- Des modèles de notification prérédigés pour le régulateur, la CNIL et les client.es. On gagne un temps précieux à ne pas les écrire sous pression.
- Un canal de communication de secours : si votre messagerie ou votre Slack est compromis, comment vous joignez-vous ? Un groupe Signal, une liste de numéros de téléphone imprimée, etc…
Réagir pendant l’incident
- Détecter : c’est tout l’intérêt de la surveillance de l’activité vue plus haut. Un incident non détecté ne peut pas être géré.
- Qualifier et classer : quelle est la gravité ? DORA définit des critères de classification (nombre de client.es touché.es, durée d’indisponibilité, perte de données, criticité des services, impact économique, répartition géographique, réputation). Ce sont eux qui déterminent si l’incident est « majeur ».
- Contenir : en cas d’attaque, isolez les machines compromises du réseau, mais ne les éteignez pas. Une machine éteinte, c’est la mémoire vive perdue, et avec elle une partie des preuves nécessaires à l’investigation.
- Communiquer : en interne, vers le régulateur, et vers les client.es si leurs intérêts financiers sont impactés. Une page de statut aide beaucoup à éviter que le support soit submergé.
- Corriger et rétablir : c’est ici que le PRA prend le relais.
Déclarer l’incident
Pour une entité financière, tout incident classé comme majeur doit être déclaré au régulateur (en France, l’ACPR ou l’AMF selon votre statut) selon des délais très courts :
- Notification initiale : dans les 4h suivant la classification de l’incident comme majeur, et au plus tard 24h après sa détection.
- Rapport intermédiaire : dans les 72h suivant la notification initiale.
- Rapport final : dans le mois suivant le dernier rapport intermédiaire, avec l’analyse des causes et les mesures prises.
Pour un sous-traitant, l’obligation est contractuelle : vous devez prévenir votre client dans des délais suffisamment courts pour qu’il puisse lui-même respecter les siens. Concrètement, si votre client a 4h pour déclarer, vous ne pouvez pas le prévenir le lendemain… D’où l’importance d’un reporting clair (rapport SLA, rapport d’incident) et de délais de notification définis dans le contrat.
DORA ne remplace pas le RGPD ! Si l’incident implique une violation de données personnelles, vous devez également la notifier à la CNIL dans les 72h. Un même incident peut donc donner lieu à plusieurs déclarations, avec des délais différents.
Apprendre après l’incident
Tous les incidents doivent être enregistrés dans un registre, même ceux qui ne sont pas majeurs. Ce registre permet de repérer les incidents récurrents, qui pris un par un semblent anodins, mais qui mis bout à bout révèlent un vrai problème.
Chaque incident significatif doit donner lieu à un post-mortem (ou retour d’expérience) : que s’est-il passé, pourquoi, comment l’a-t-on détecté, qu’est-ce qui a bien ou mal fonctionné, et quelles actions mettre en place pour que ça ne se reproduise pas. Comme pour le signalement des comportements suspects, le post-mortem doit être fait sans recherche de coupable : l’objectif est de corriger le système, pas de trouver un.e responsable. Sinon, la prochaine fois, plus personne ne déclarera rien…
Exemple de risque en cas de manquement de gestion des incidents :
- Déclaration hors délai au régulateur, exposant l’entité à une sanction.
- Décisions improvisées sous la pression (machines éteintes et preuves détruites, rançon payée sans garantie).
- Impossibilité de joindre les équipes, car la messagerie de l’entreprise est elle-même compromise.
- Le même incident qui se reproduit tous les mois faute d’analyse des causes.
C’est une obligation dans le cadre de DORA et elle est abordée dans les articles 17 à 19.
Tests de résilience
Avoir un PRA, une infrastructure 3-AZ et une procédure de gestion des incidents, c’est bien. Mais tant que ce n’est pas testé, ce n’est qu’une hypothèse… DORA impose un programme de tests et demande que les systèmes supportant des fonctions critiques soient testés au moins une fois par an.
Tester sa sécurité :
- Scans de vulnérabilités automatisés en continu, comme vu dans la partie veille et surveillance CVE.
- Audit de sécurité (test d’intrusion, audit de configuration, revue de code) au moins une fois par an, et à chaque évolution majeure de l’application ou de l’infrastructure. DORA exige que les tests soient réalisés par des personnes indépendantes, internes ou externes.
- TLPT (Threat-Led Penetration Testing) tous les trois ans, uniquement pour les entités désignées par le régulateur.
Tester sa résilience technique :
- Simulation de panne : sur une infrastructure 3-AZ, on peut par exemple couper une zone complète afin de vérifier que l’application continue à fonctionner normalement. Sur Kubernetes, des outils comme Chaos Mesh ou LitmusChaos permettent de simuler des pannes (pods supprimés, latence réseau, nœud indisponible, etc…). C’est ce qu’on appelle le chaos engineering.
- Tests de charge : votre application tient-elle un pic de trafic (fin de mois, campagne marketing, attaque DDoS) ? Des outils comme k6 ou Gatling permettent de le vérifier avant que vos client.es ne le fassent pour vous.
- Test de restauration des sauvegardes : une sauvegarde qui n’a jamais été restaurée n’est pas une sauvegarde, c’est un espoir.
Tester son organisation :
- Exercice de crise : simulez un scénario réaliste (ransomware un vendredi soir, fuite de données relayée par la presse, etc…) avec l’ensemble des personnes concernées, direction comprise. C’est le meilleur moyen de vérifier que la procédure de gestion des incidents fonctionne, que les contacts sont à jour et que tout le monde sait quoi faire. L’ANSSI propose d’ailleurs un guide pour organiser un exercice de gestion de crise cyber.
Un test n’a d’intérêt que s’il est suivi d’actions. Chaque vulnérabilité ou dysfonctionnement découvert doit être priorisé, corrigé, puis retesté pour vérifier que la correction fonctionne.
Exemple de risque en cas d’absence de tests :
- Bascule sur la zone de secours qui échoue le jour où on en a réellement besoin.
- Sauvegardes corrompues ou incomplètes découvertes au moment de la restauration.
- Vulnérabilité critique découverte par une personne malveillante plutôt que par un.e auditeur.rice.
C’est une obligation dans le cadre de DORA et elle est abordée dans les articles 24 à 27.
Risque lié aux prestataires tiers
Externaliser un service ne veut pas dire externaliser sa responsabilité : avec DORA, l’entité financière reste entièrement responsable du respect de ses obligations, même lorsque le service est assuré par un prestataire.
Elle doit donc tenir un registre d’informations recensant l’ensemble de ses contrats TIC, transmis chaque année au régulateur, et évaluer les risques avant chaque nouveau contrat, notamment le risque de concentration.
Les contrats doivent contenir des clauses obligatoires : description précise des services, localisation des données, niveaux de service, assistance en cas d’incident, droit d’audit, conditions de résiliation et, pour les fonctions critiques ou importantes, une stratégie de sortie testée (réversibilité) permettant de changer de prestataire sans interruption de service. Enfin, les prestataires jugés critiques pour l’ensemble du secteur (les grands fournisseurs cloud notamment) sont directement supervisés par les autorités européennes.
Pour un sous-traitant, cela se traduit très concrètement par des questionnaires de sécurité, des demandes d’audit et des avenants contractuels : mieux vaut avoir ses politiques, certifications et rapports prêts en amont.
C’est une obligation dans le cadre de DORA et elle est abordée dans les articles 28 à 30.
Sanctions en cas de manquement
En cas de manquement, une entité financière s’expose à des sanctions mais elles ne sont pas précisées par le règlement européen tout dépend de l’entité, du manquement et de l’application par le pays en question.
Dans le cas d’un prestataire TIC critique, il peut y avoir des astreintes journalières allant jusqu’à 1% du chiffre d’affaires quotidien mondial pendant 6 mois maximum.
À ce jour, il n’y a pas encore eu d’amende par l’ACPR ou l’AMF dans le cadre de manquements à DORA.
En revanche, le rapport 2025 de l’AMF pour certains types de société sur les incidents majeurs liés à DORA est disponible et consultable ici : Rapports incidents majeurs liés à DORA déclarés à l’AMF en 2025
Conclusion – Avec tout ça suis-je conforme à DORA ?
Oui, vous avez ce qu’il vous faut pour être conforme à DORA.
Ce qui est proposé ici n’est peut-être pas pertinent pour votre société (en dehors des obligations et du principe de proportionnalité), il y a une évaluation à faire en amont évidemment.
Nous vous recommandons d’un point de vue technique et sensibilisation de vous attarder en priorité sur les points suivants :
- Gestion PCA/PRA
- Surveillance de l’activité et remontée d’alerte
- Sensibilisation des collaborateur.rices face au risque cybersécurité.
Remerciements :
- Alexandre GUY : Pour la relecture et le design des schémas.
- Nicolas ROULON et Thomas GUEMERT : Pour la relecture.
- Bérénice CARRERE : Pour la publication et communication.